PHPでOGPを取得する — PHP 8.4 の新しいDOM APIで書く
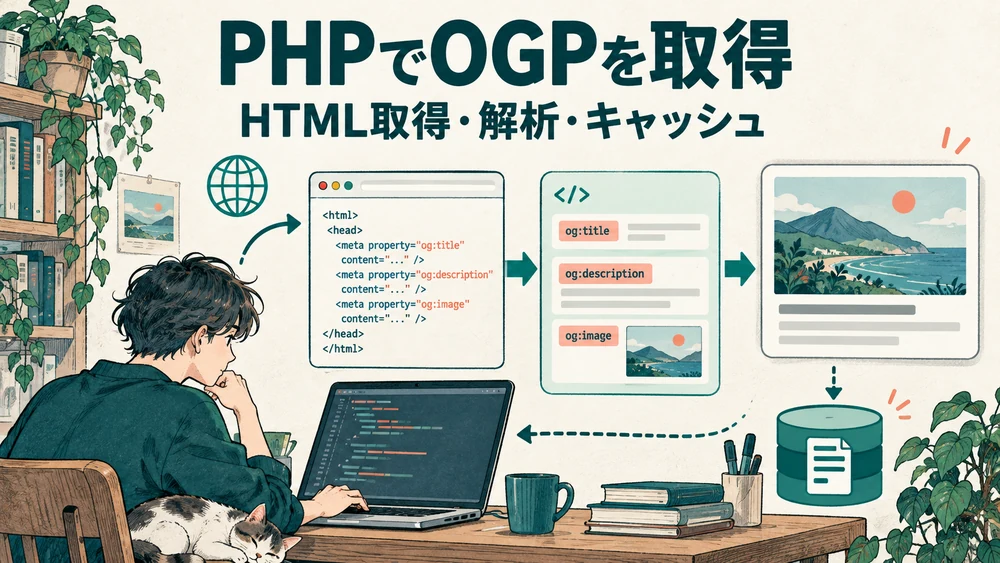
外部URLを渡すとタイトル・画像・説明が返ってくる。 ブログカードを自作するときに必ず要る処理です。
この処理、日本語で検索すると2012年ごろのやり方がそのまま出てきます。 実際、上位の記事の何本かは2016年で更新が止まっているライブラリを今も勧めています。 PHP側は8.4でHTMLを正しくパースする標準APIが入ったので、もう外部ライブラリは要りません。
この記事はいま書くならこうという形でまとめます。
先に結論
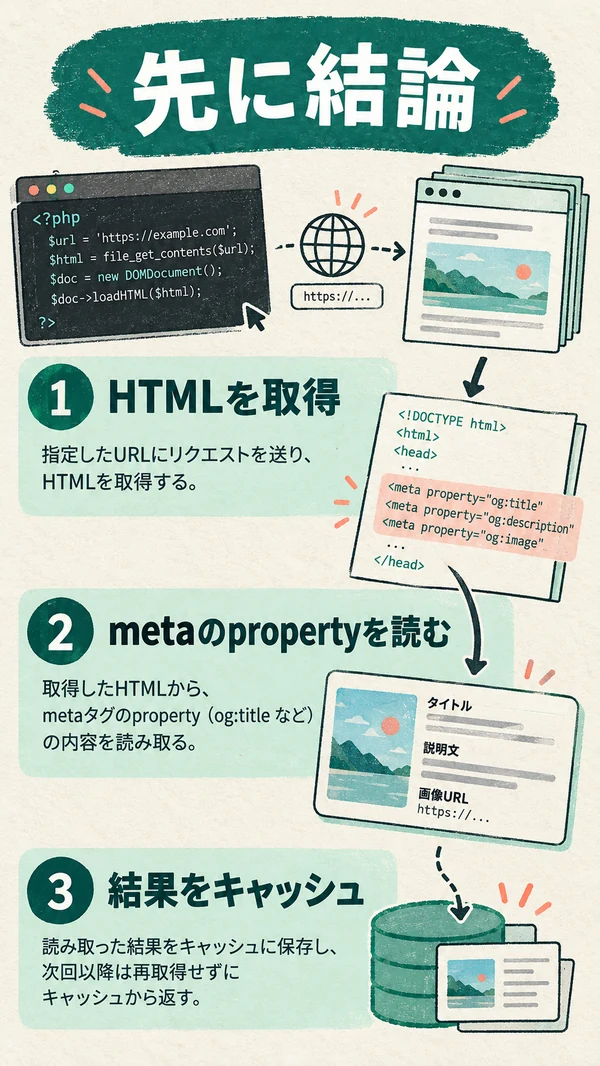
PHP 8.4以降なら、これだけで取れます。
ogp.php
<?php
function fetchOgp(string $url): array
{
    $html = httpGet($url);          // 取得は後述
    if ($html === null) return [];

    $dom = \Dom\HTMLDocument::createFromString($html, LIBXML_NOERROR);

    $og = [];
    foreach ($dom->getElementsByTagName('meta') as $meta) {
        $prop = $meta->getAttribute('property');
        if (str_starts_with($prop, 'og:')) {
            $og[substr($prop, 3)] = $meta->getAttribute('content');
        }
    }
    return $og;
}

$og = fetchOgp('https://example.com/');
echo $og['title']   ?? '';
echo $og['image']   ?? '';
echo $og['description'] ?? '';
ポイントは1行目の \Dom\HTMLDocument::createFromString() です。
PHP 8.4 で入った新しいDOM APIで、HTMLの仕様(living standard)に沿ってパースします。
壊れたHTMLでも実際のブラウザと同じ解釈をしてくれるので、正規表現やライブラリが要らなくなりました。
| やり方 | 2026年の評価 |
|---|---|
Dom\HTMLDocument | これを使う(PHP 8.4以降・標準・外部依存なし) |
DOMDocument::loadHTML() | 8.4未満ならこれ。警告の抑制と文字コード対策が要る |
get_meta_tags() | 使えない(理由は次の章) |
正規表現(preg_match) | 動くが壊れやすい。属性の順序・引用符・改行で崩れる |
| 外部ライブラリ | いまは要らない |
get_meta_tags() では取れない
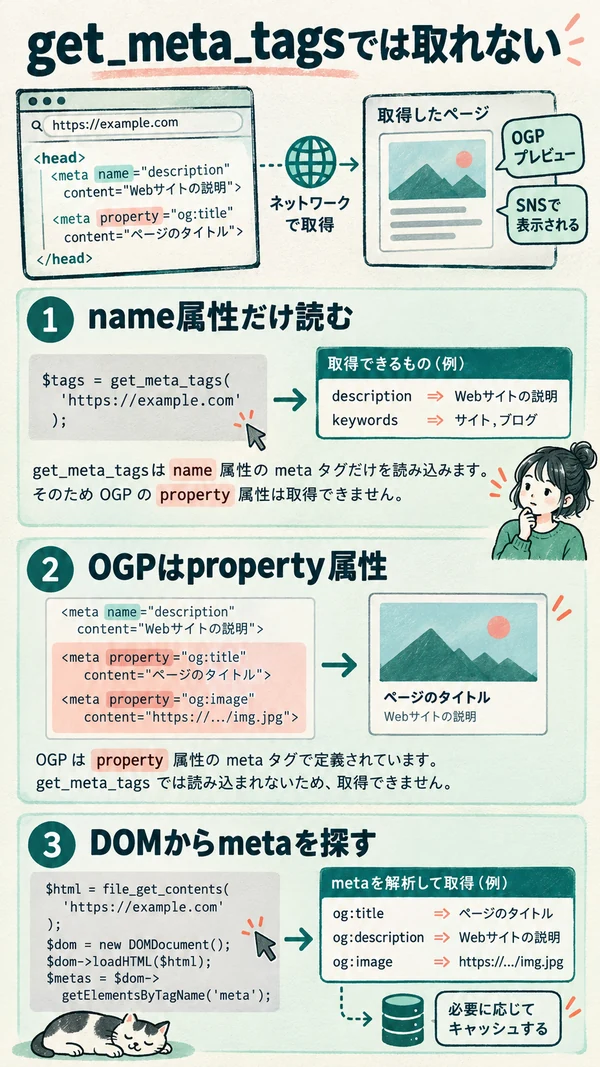
PHPにはget_meta_tags()という、いかにも使えそうな標準関数があります。
でもOGPは取れません。公式マニュアルにこう書いてあります。
Only meta tags with name attributes will be parsed.
(name属性を持つmetaタグだけがパースされます)
OGPのmetaタグはproperty属性です。
| 種類 | 書き方 | get_meta_tags() |
|---|---|---|
| 通常のmeta | <meta name="description" content="..."> | 取れる |
| OGP | <meta property="og:title" content="..."> | 取れない |
| Twitter Card | <meta name="twitter:card" content="..."> | 取れる |
ややこしいのはTwitter Cardはname属性なので取れてしまうことです。
「meta取得の関数があるのにOGPだけ空になる」という詰まり方をします。原因はこれです。
現行のやり方:Dom\HTMLDocument
PHP 8.4 で入った
公式マニュアルのシグネチャはこうです。
Dom\HTMLDocument::createFromString(PHP 8 >= 8.4.0)
public static function Dom\HTMLDocument::createFromString(
    string $source,
    int $options = 0,
    ?string $overrideEncoding = null
): Dom\HTMLDocument| 引数 | 内容 |
|---|---|
$source | パースするHTMLの文字列 |
$options | libxmlのオプション定数のビット論理和 |
$overrideEncoding | 文書の文字コード。渡さない場合は最も可能性の高いエンコーディングを判定しようとする |
説明は「Parses an HTML document from a string, according to the living standard.」。
HTML Living Standardに沿ってパースすると明記されています。
ここが従来のDOMDocument::loadHTML()との決定的な違いです。
なぜ正規表現を使わないのか
preg_match('/<meta property="og:title" content="(.*?)"/', ...) のような書き方は、
動くときは動きます。壊れるパターンが多すぎるのが問題です。
| 実際にあるHTML | 素朴な正規表現 |
|---|---|
<meta content="..." property="og:title">(属性の順序が逆) | 取れない |
<meta property='og:title' content='...'>(シングルクォート) | 取れない |
| 属性の間に改行が入っている | 取れない(s修飾子が要る) |
contentの中に " やエスケープが入る | 途中で切れる |
<meta property="og:title:alt"> のような近い名前 | 誤爆する |
全部つぶそうとすると、結局HTMLパーサを書くことになります。 標準にパーサが入った以上、そちらを使うほうが早くて正確です。
PHP 8.4 未満の環境なら
従来のDOMDocumentでも書けます。ただし2つ手当てが要ります。
PHP 8.0〜8.3
$dom = new DOMDocument();
// ① パースエラーの警告を止める
libxml_use_internal_errors(true);
// ② 文字コードを明示する(これが無いと日本語が化ける)
$dom->loadHTML('<?xml encoding="UTF-8"?>' . $html, LIBXML_NOERROR | LIBXML_NOWARNING);
libxml_clear_errors();

$og = [];
foreach ($dom->getElementsByTagName('meta') as $meta) {
    $prop = $meta->getAttribute('property');
    if (str_starts_with($prop, 'og:')) {
        $og[substr($prop, 3)] = $meta->getAttribute('content');
    }
}
loadHTML() は文字コードを推測しません。
何も指定しないとISO-8859-1として扱われ、日本語が確実に化けます。
<?xml encoding="UTF-8"?> を頭に足すのが定番の回避策です。
8.4のDom\HTMLDocumentはエンコーディングを判定しようとするので、この手当てが不要になります。
移行する価値はここにもあります。
取得部分(HTTPの取り方)
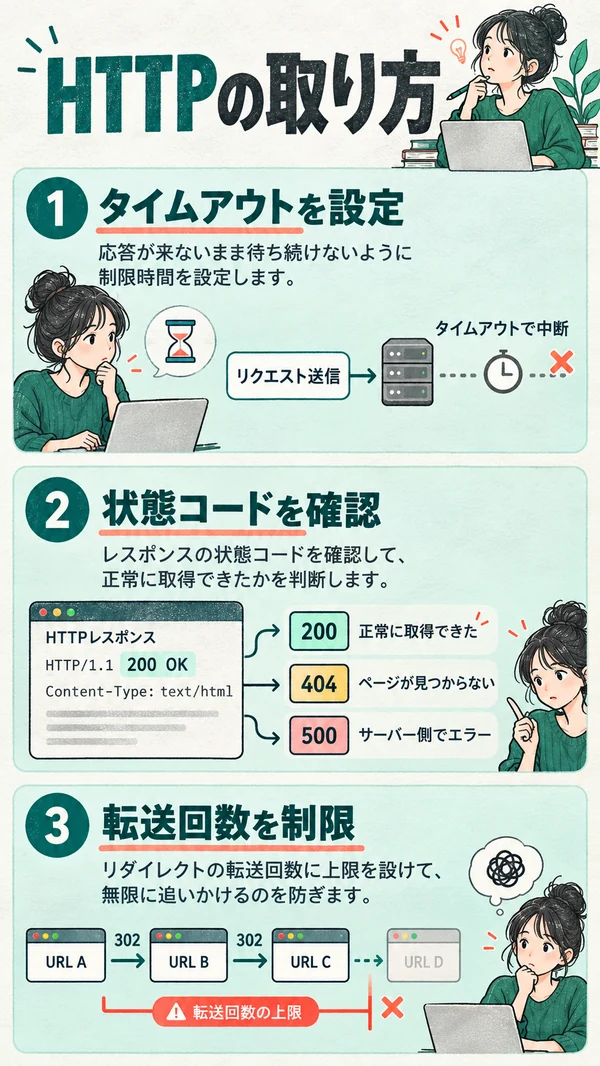
パースの前にHTMLを取ってくる必要があります。ここを雑に書くと本番で止まります。
file_get_contents の問題
最短で書けるのはこれです。
動くが本番向きではない
$html = file_get_contents($url);| 問題 | 何が起きるか |
|---|---|
| タイムアウトが長い | 相手が応答しないと、既定のソケットタイムアウトまで待つ。ページ表示が固まる |
| User-Agentが無い | UAで弾くサイトがあり、403や空が返る |
| リダイレクトの制御ができない | 無限リダイレクトに付き合わされる |
| HTTPステータスを見ない | 404のエラーページをパースして空の結果を返す |
allow_url_fopen | サーバー側で無効ならそもそも動かない |
cURLで最低限やること
httpGet()
function httpGet(string $url, int $timeout = 5): ?string
{
    // ① http/https 以外は弾く
    $scheme = parse_url($url, PHP_URL_SCHEME);
    if (!in_array($scheme, ['http', 'https'], true)) return null;

    $ch = curl_init($url);
    curl_setopt_array($ch, [
        CURLOPT_RETURNTRANSFER => true,
        CURLOPT_FOLLOWLOCATION => true,
        CURLOPT_MAXREDIRS      => 3,
        CURLOPT_TIMEOUT        => $timeout,   // ② 全体のタイムアウト
        CURLOPT_CONNECTTIMEOUT => 3,          //    接続までのタイムアウト
        CURLOPT_USERAGENT      => 'Mozilla/5.0 (compatible; OgpFetcher/1.0)',
        CURLOPT_ENCODING       => '',         // ③ gzipを受け取る
    ]);
    $body = curl_exec($ch);
    $code = curl_getinfo($ch, CURLINFO_RESPONSE_CODE);
    $type = curl_getinfo($ch, CURLINFO_CONTENT_TYPE);
    curl_close($ch);

    // ④ 200以外とHTML以外は捨てる
    if ($body === false || $code !== 200) return null;
    if ($type && !str_contains($type, 'html')) return null;

    return $body;
}| やっていること | これが無いと | |
|---|---|---|
| ① | スキームを http/https に限定 | file:// などを渡されてサーバー内のファイルを読まれる |
| ② | タイムアウトを明示 | 応答しない相手にページ表示が引きずられる |
| ③ | gzipを受け取る | 転送量が数倍になる |
| ④ | ステータスとContent-Typeを確認 | 404ページやPDFをパースして空を返す |
①は地味ですがセキュリティに直結します。 ユーザーが入力したURLをそのまま取りに行く機能は、 社内ネットワークやクラウドのメタデータサーバーへのアクセスに悪用されうるという既知の問題があります。 自分のサイトの中のURLだけを扱うなら、ホスト名のホワイトリストで絞るのが一番安全です。
まだ古いライブラリを勧めている記事がある
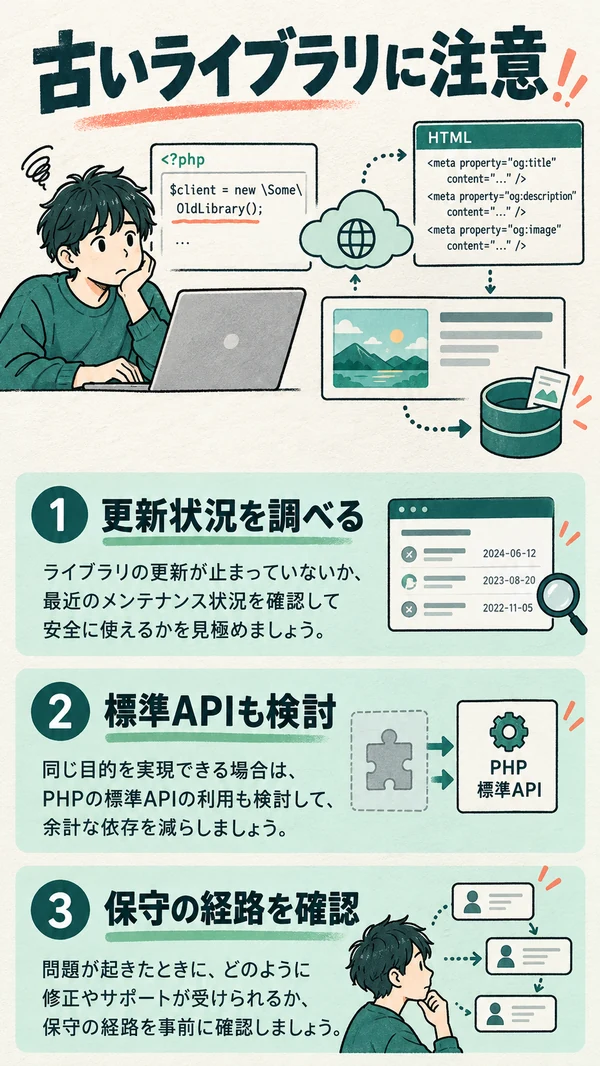
「php ogp 取得」で検索すると、OpenGraph.php という単一ファイルのライブラリを使う記事が今も上位に出てきます。 このライブラリの現状を確認しました。
| 項目 | 状況(2026年10月25日時点) |
|---|---|
| リポジトリ作成 | 2010年4月 |
| 最後の更新 | 2016年12月(約10年前) |
| 未解決のissue | 35件 |
| Composerでの導入 | 不可(Packagistに登録が無い) |
| star | 467 |
悪いライブラリという意味ではありません。2012年当時は、これが一番ラクな方法でした。 問題は10年前に止まったものが、今も「おすすめ」として紹介され続けていることです。
Composerで入らない時点で、運用上の扱いが変わります。 ファイルを手でダウンロードしてリポジトリに置く=更新の経路が無いということです。 脆弱性が見つかっても気づけませんし、PHPのバージョンを上げたときに動くかも自分で確かめるしかありません。
標準APIで20行ほど書けば済む処理に、更新されない外部ファイルを持ち込む理由はもうありません。
なおHTMLパーサとして定番だった simplehtmldom も、Packagist上の最新は2019年のRC版で止まっています。 どうしても高機能なパーサが要るなら、symfony/dom-crawler のように更新が続いているものを選んでください。
詰まるところ
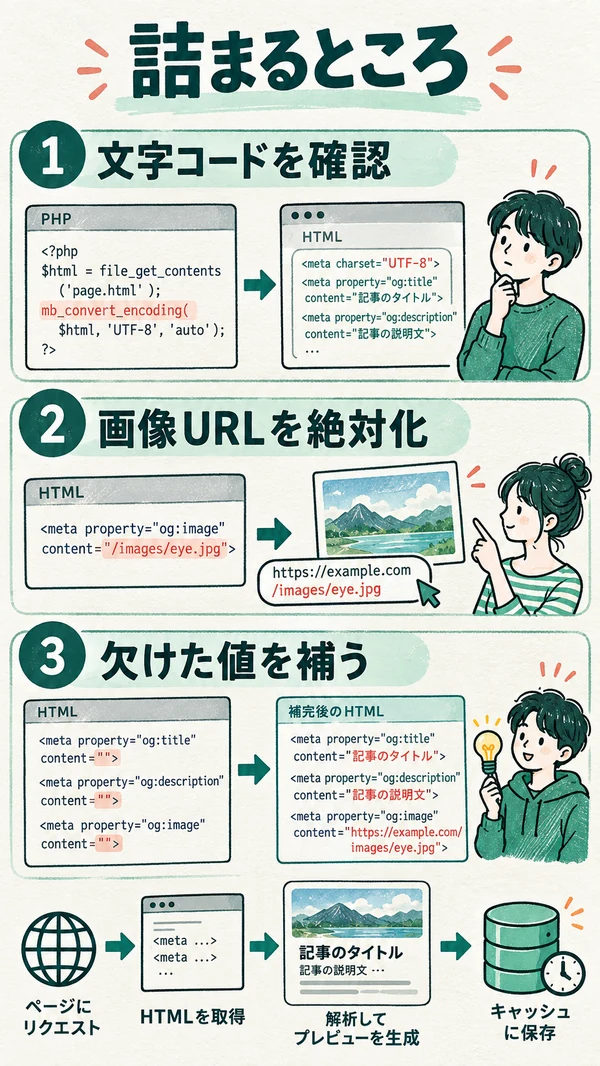
動くようになってから出てくる問題をまとめます。
文字コード
日本語サイトを取るとタイトルが化けることがあります。原因は2つです。
| 原因 | 対処 |
|---|---|
| 相手がUTF-8ではない(EUC-JP・Shift_JISの古いサイト) | createFromString() の第3引数で明示するか、mb_convert_encoding() で変換 |
DOMDocument::loadHTML() を使っている | 文字コードを推測しないので必ず明示する(前述) |
Dom\HTMLDocument は「最も可能性の高いエンコーディングを判定しようとする」と公式に書かれています。
ほとんどの場合は任せて問題ありませんが、判定に失敗したときは第3引数で上書きしてください。
og:image が相対URLで返ってくる
仕様上は絶対URLであるべきですが、相対パスで書いているサイトが実際にあります。
そのまま <img src> に入れると、自分のドメインを基準に解決されて画像が出ません。
絶対URLに直す
function toAbsoluteUrl(string $maybeRelative, string $baseUrl): string
{
    if (preg_match('#^https?://#i', $maybeRelative)) return $maybeRelative;

    $p = parse_url($baseUrl);
    $origin = $p['scheme'] . '://' . $p['host']
            . (isset($p['port']) ? ':' . $p['port'] : '');

    // //example.com/img.png
    if (str_starts_with($maybeRelative, '//')) return $p['scheme'] . ':' . $maybeRelative;
    // /img.png
    if (str_starts_with($maybeRelative, '/'))  return $origin . $maybeRelative;
    // img.png
    $dir = rtrim(dirname($p['path'] ?? '/'), '/');
    return $origin . $dir . '/' . $maybeRelative;
}
リダイレクトされた場合は、最終URLを基準にしてください。
cURLなら curl_getinfo($ch, CURLINFO_EFFECTIVE_URL) で取れます。
元のURLを基準にすると、相対パスの解決先がずれます。
JavaScriptで描画されるページ
HTMLを取っても中身が空というケースがあります。 OGPのmetaタグをJavaScriptで後から挿入しているサイトです。
cURLはJavaScriptを実行しません。取れるのは最初に返ってきたHTMLだけです。
| 状況 | 対処 |
|---|---|
| metaがサーバー側で出ている(大半のサイト) | この記事の方法で取れる |
| metaをJSで挿入している | cURLでは取れない。ヘッドレスブラウザか、取得APIを使う |
| そもそもOGPが無い | フォールバックする(次項) |
まず切り分けてください。
curl -s URL | grep 'og:' をターミナルで叩いて、何も出ないならJS描画かOGP自体が無いかです。
PHP側のコードをいくら直しても出てきません。
og:title や og:image が無いとき
OGPを設定していないサイトはいくらでもあります。空のカードを出さないよう、代わりの値を拾います。
| 欲しいもの | 第1候補 | 代わりに見るもの |
|---|---|---|
| タイトル | og:title | <title> |
| 説明 | og:description | <meta name="description"> |
| 画像 | og:image | <link rel="icon"> か、自前の既定画像 |
| サイト名 | og:site_name | ホスト名 |
フォールバック込み
$title = $og['title']
      ?? $dom->getElementsByTagName('title')->item(0)?->textContent
      ?? parse_url($url, PHP_URL_HOST);
キャッシュしないと事故る
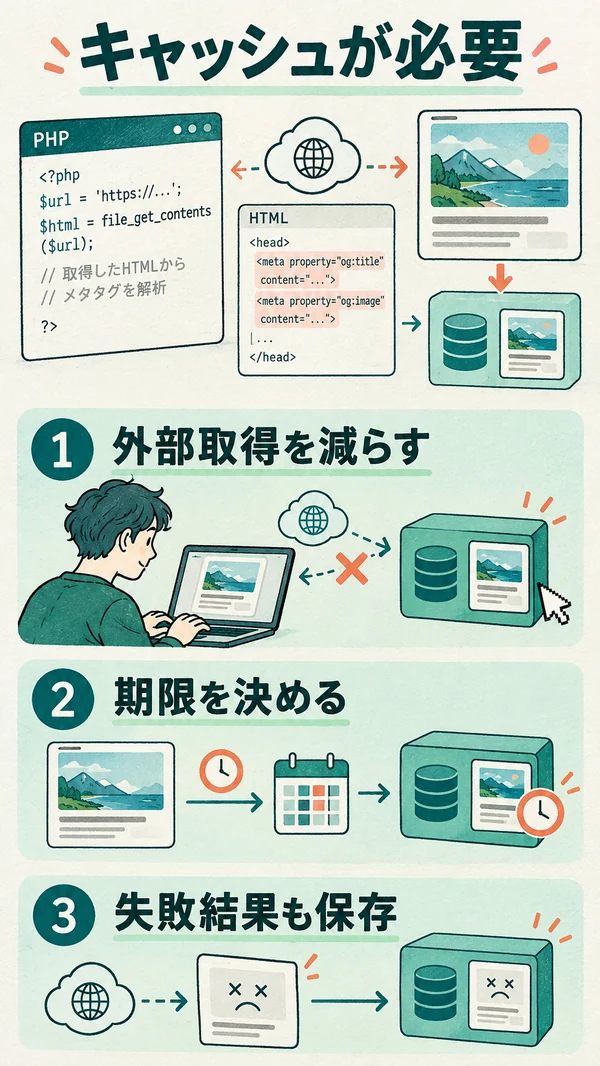
これが一番大事かもしれません。 ページを開くたびに外部サイトへ取りに行く実装にすると、次が起きます。
- 自分のページの表示が、相手サーバーの速度に引きずられる
- 相手が落ちているとタイムアウトぶん待たされる
- アクセスが増えると相手に迷惑をかける(場合によってはブロックされる)
| 保存先 | 向いている場面 | 注意 |
|---|---|---|
| ファイル | 共用サーバー。追加設定が要らない | URLを hash() してファイル名にする |
| データベース | WordPressならトランジェントが使える | 有効期限を必ず設定する |
| Redis等 | 自分で構成を決められる環境 | 共用サーバーでは使えないことが多い |
有効期限は長めで構いません。記事のタイトルや画像は頻繁には変わりません。 1週間から1ヶ月を目安にして、必要なら手動で消せるようにしておけば十分です。
取得に失敗した結果もキャッシュしてください。 これをやらないと、OGPの無いサイトへのリンクがあるたびに毎回取りに行くことになります。
AIでやるなら
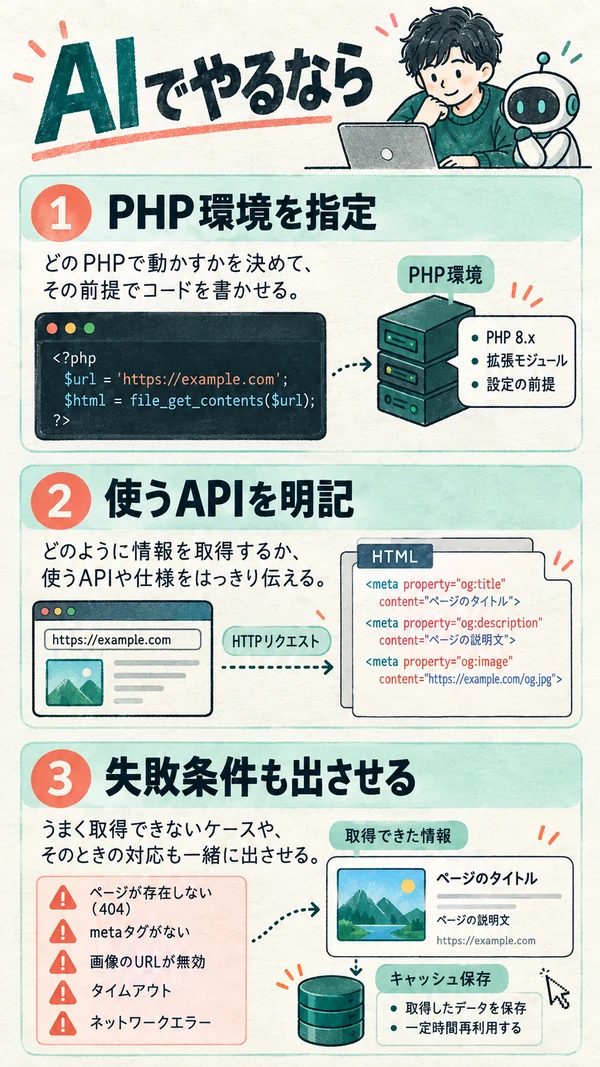
この処理はAIに書かせるのに向いています。仕様が決まっていて、検証もしやすい。 ただ何も指定しないと2012年のコードが出てきます。学習データに古い記事が大量にあるからです。
環境を固定して書かせる
プロンプト
PHPで、URLを渡すとOGP(og:title / og:image / og:description)を
返す関数を書いてください。

【環境】
- PHP 8.4
- 外部ライブラリは使わない(Composerも使わない)

【必ず守ること】
- HTMLのパースは \Dom\HTMLDocument::createFromString() を使う
- 正規表現でmetaタグを探さない
- get_meta_tags() は使わない(property属性を読めないため)
- 取得は cURL。タイムアウトを必ず設定する
- HTTPステータスが200でなければ null を返す

【あわせて書いてほしいこと】
- og:image が相対URLだった場合に絶対URLへ直す処理
- og:title が無い場合に <title> を使うフォールバック

コードの後に、この関数が失敗する条件を箇条書きで挙げてください。
「使わないもの」を明示するのが効きます。
get_meta_tags() や正規表現を禁じておかないと、
動くけれど壊れやすいコードが返ってきます。
AIは「よく見た書き方」を出すので、よく見た書き方が古い領域では先に封じるしかありません。
最後の「失敗する条件を挙げて」も入れてください。 JS描画・文字コード・リダイレクトあたりを自分で挙げてくれるので、テストすべき項目がそのまま出てきます。
出てきたコードの検証
動かす前に、この4点だけ目で見てください。
| 見るところ | NGなら |
|---|---|
preg_match でmetaを探していないか | 属性の順序が違うHTMLで壊れる |
get_meta_tags() を使っていないか | OGPが空で返る |
| タイムアウトを設定しているか | 相手が落ちたとき自分のページが固まる |
| HTTPステータスを見ているか | 404ページをパースして空を返す |
そのうえで、実際のURLで試すのが確実です。
| 試すURL | 確認できること |
|---|---|
| OGPが揃っている普通の記事 | 基本動作 |
| OGPが無いページ | フォールバックが効くか |
| リダイレクトするURL(短縮URLなど) | 追従と、相対URLの基準 |
| 存在しないURL(404) | エラー時に落ちないか |
| 日本語のタイトルが長いページ | 文字化けしないか |
答えがズレたときの直し方
- 古い書き方で返ってきた
- 「PHP 8.4の
\Dom\HTMLDocumentを使って書き直して」とクラス名を名指しする。「最新で」では伝わりません。 - エラー処理が無い
- 「相手が落ちている / 404 / OGPが無い の3つで、それぞれ何が返るか」を聞く。穴が自分で出てきます。
- 長すぎる
- 「取得とパースを別の関数に分けて」。キャッシュを足すときに効いてきます。
よくある質問
- get_meta_tags() でOGPが取れません
- 取れません。公式マニュアルに「Only meta tags with name attributes will be parsed.」とあり、name属性のmetaタグしか読みません。OGPは
property属性なので対象外です。 - 外部ライブラリは必要ですか
- PHP 8.4以降なら不要です。
\Dom\HTMLDocument::createFromString()が標準で使えます。よく紹介されているOpenGraph.phpは2016年12月で更新が止まっていて、Composerにも登録がありません。 - 正規表現ではだめですか
- 動くときは動きます。ただし属性の順序・引用符の種類・改行で簡単に壊れます。標準のパーサが使える以上、使わない理由がありません。
- 日本語が文字化けします
DOMDocument::loadHTML()を使っていませんか。この関数は文字コードを推測せず、既定でISO-8859-1として扱います。<?xml encoding="UTF-8"?>を先頭に足すか、8.4のDom\HTMLDocumentに移ってください。- OGPが空で返ってきます
- まず
curl -s URL | grep 'og:'でHTMLにOGPが入っているかを確認してください。何も出なければJavaScriptで挿入しているか、そもそもOGPが無いので、PHP側を直しても解決しません。 - og:image が表示されません
- 相対URLで書かれている可能性があります。絶対URLに直す処理を通してください。リダイレクトした場合は最終URLを基準に解決します。
- 毎回取りに行っても大丈夫ですか
- やめてください。自分のページの表示速度が相手サーバーに引きずられますし、相手にも負荷をかけます。1週間〜1ヶ月のキャッシュを入れて、失敗した結果もキャッシュしてください。
まとめ
- PHP 8.4 の
\Dom\HTMLDocument::createFromString()を使う。
HTML Living Standardに沿ってパースするので、壊れたHTMLでもブラウザと同じ解釈になります。 get_meta_tags()では取れない。
公式に「name属性のmetaタグだけ」と書かれています。OGPはproperty属性です。- 取得側のタイムアウトとキャッシュを先に入れる。
ここを省くと、相手サーバーの不調が自分のページの不調になります。
14年前はライブラリを入れるのが一番ラクでした。今は標準で20行です。 検索で出てくるコードをコピーする前に、それがいつ書かれたものかを見てください。
スクレイピングでセレクタを決める話は スクレイピングで要素を取得する、 PHPの学び方は PHPの勉強法 に書きました。 動かす場所が要るなら レンタルサーバーおすすめ8選 も参考にしてください。
公式情報は2026年10月25日時点で php.net と GitHub から確認したものです。
PHPのバージョンによって使えるAPIが違うので、
php -v で自分の環境を確認してから選んでください。